01.1
以“主动表达 + 可确认执行”降低持续记账的阻力。
用户不是没有消费管理意愿;问题在于记账的即时操作成本,高于当下能够感知的收益。money mate 让用户用语音或文字说出完整消费事实,由 智能理解、由 Tool 真实执行,并保留确认步骤。
低摩擦,但不是零摩擦。智能模型负责理解,用户保留最终确认权。
消费管理智能体 · 语音优先
把“记账”从填写表单,变成说一句话。
以语音优先、自然语言理解与可确认执行为核心的消费记录 Agent。MVP 不承诺“无感记账”,而是验证一条更低摩擦、仍然可信的记录路径。
01
用户不是没有消费管理意愿;问题在于记账的即时操作成本,高于当下能够感知的收益。money mate 让用户用语音或文字说出完整消费事实,由 智能理解、由 Tool 真实执行,并保留确认步骤。
低摩擦,但不是零摩擦。智能模型负责理解,用户保留最终确认权。
02
研究用于发现问题、形成假设与定义 MVP,不被表述为统计显著结论。
“记一段时间➡️摆烂➡️记一段时间➡️摆烂”
分类过细增加记录判断与分析负担。
“每天晚上写 done 和第二天 todo 的时候,很自然就会记账了。”
单独启动记账需要额外意志力。
“每次记账先纠结 3 秒,算了,不记了。”
复杂录入、分类纠结和流水无价值感放大放弃概率。
“记了一年的账,感觉没有效果,也不会记。”
完成记录后仍缺少数据解释、目标关联和行动指导。
“直接点一下就跳转开始打字或语音记账,对懒人也是非常之友好。”
小组件承担提醒与缩短入口;逐项填写的路径太长。
Evidence:用户 1 减少分类复杂度;用户 3 前三天因录入麻烦、分类纠结放弃。
Insight:记录和分类是获得洞察前必须支付的操作成本。
Evidence:用户 2 用 done/todo 创造触发;用户 5 用小组件提醒。
Insight:入口更近、时机更自然同样重要;提醒属于后续机会。
Evidence:用户希望判断消费价值;只记录流水难以复盘;记一年仍不会用。
Insight:成功写入流水不等于用户获得价值。
他们关心钱去了哪里、哪些花得值得或浪费、下一阶段怎样调整、如何制定预算。
Insight:记账是理解消费与改善行为的手段。
| 研究结论 | 产品判断 | MVP 决策 |
|---|---|---|
| 竞争对象不是另一款功能更多的 App,而是“稍后再记 / 算了,不记了”。 | 即时成本比收益更可感知。 | 优先缩短核心路径,而非堆预算、图表和分类。 |
| 传统:打开 App → 新建 → 输入金额 → 选择分类 → 设置日期 → 备注 → 保存。 | 高频重复的字段拆分会累积为负担。 | 说一句 / 输入一句 → 智能理解 → Tool 执行 → 完成记录。 |
| 长期机会:记录 → 统计 → 反馈 → 提醒 → 复盘 → 行为改善。 | “管钱搭子”也应提供数据解释。 | 本次 Demo 只验证最核心假设,其余进入 Roadmap。 |
03
以鲨鱼记账为代表的传统结构化路径,已解决入口不清、上手困难和一次面对太多字段的问题:底部「+」明显,过程有逐步引导,视觉也相对克制。
发生消费 → 想起要记账 → 点击「+」→ 选择消费分类 → 输入金额 → 输入备注 → 必要时修改日期 → 完成 → 返回账单总览用户脑中的“昨天买了一条红色裙子,140 元”,仍需手动拆为金额、分类、日期、备注。高频下,分类判断、日期补记,以及对资产图表的主动解释,持续产生摩擦。
通知抓取、支付截图识别、OCR、快捷指令和系统级能力,验证了“减少逐笔输入”是成立的需求。一木记账、iCost、木木记账、钱迹,Android 系统能力与 iPhone 快捷指令都属于这个方向。
| 新增约束 | 具体表现 |
|---|---|
| 权限与兼容 | 通知读取、悬浮窗、屏幕读取、截图受系统限制;iOS 多依靠快捷指令 + 截图 + OCR。 |
| 授权稳定 | 权限可能失效,不同支付平台识别时效不同。 |
| 识别与校正 | 可能漏记、重复、错分;还款、电商内部页面也会增加人工检查。 |
| 隐私成本 | 读取通知、屏幕或支付页面带来交易数据与授权顾虑。 |
“自动记账虽然方便,但是其实不利于让自己有‘花钱’的感觉。”
摩擦越低不必然价值越高:全自动可能提高覆盖率,却降低消费感知、主动复盘意愿和对支出结构的关注。
怎样在减少无价值录入成本的同时,保留用户对消费行为的感知?
| 方案 | 优势 | 限制 | money mate 的取舍 |
|---|---|---|---|
| 传统表单 | 字段明确、确定性强 | 用户主动拆分信息,步骤多 | 保留确认的确定性,用自然语言降录入成本。 |
| 自动抓账 / 账单同步 | 减少输入 | 接入、隐私、账单来源与即时表达覆盖受限 | 不追求全自动抓取,先验证主动表达的 MVP。 |
| 通用聊天机器人 | 对话灵活 | 可能只“回答”,不保证真实执行 | Tool + SQLite,将理解与执行分离。 |
本期能力:自然语言 / 语音记账、一次多笔、金额提取、自动分类、相对日期、Function Calling、SQLite、消费查询与每日汇总。
后续 Roadmap:主动提醒、个性化分类、周/月复盘、异常识别、预算建议、主动分析、个性化反馈风格及更完整的“管钱搭子”体验。
04
“昨天中午吃饭 35,晚上打车 22”天然包含时间、金额、类型、描述与多笔;LLM 可承担过去由用户完成的字段拆分。
“给妈妈买生日礼物花了 300”不只是关键词购物;价值 / 情绪 / 生存等个性分类更依赖上下文。
长期可以解释“为什么变多、哪些天最高、是否调整”。这是 Roadmap,不是当前 MVP 的第一验证目标。
不让 LLM 直接“假装完成记账”。LLM 负责理解意图、提取参数、识别分类与相对日期;Tool 负责写库、查询与统计。这一分层减少幻觉、误写与不可控执行。
| 模块 | 负责 | 不负责 |
|---|---|---|
| STT | 录音转文本 | 自动记账、改数据库 |
| LLM | 理解语言、意图、Tool 选择 | 自行宣称写库成功 |
| Tool | 写入、查询、汇总 | 模糊语义理解 |
| SQLite | 真实持久化与查询 | 自然语言解释 |
| UI | 转写编辑、确认、执行反馈 | 暴露技术调试信息 |
Input文字与语音复用 Agent;录音停止后自动转写并可编辑。
Understanding支持单笔 / 多笔、金额、类别、相对日期与非记账内容正常回复。
Execution用户确认后执行;写入、查询、汇总来自 SQLite,最终只写确认值。
UI移动端优先:语音入口突出、输入固定、反馈可滚动。
Not in scope自动抓支付账单、预算与主动提醒、原生 App / 后台录音、留存或商业化效果。
05
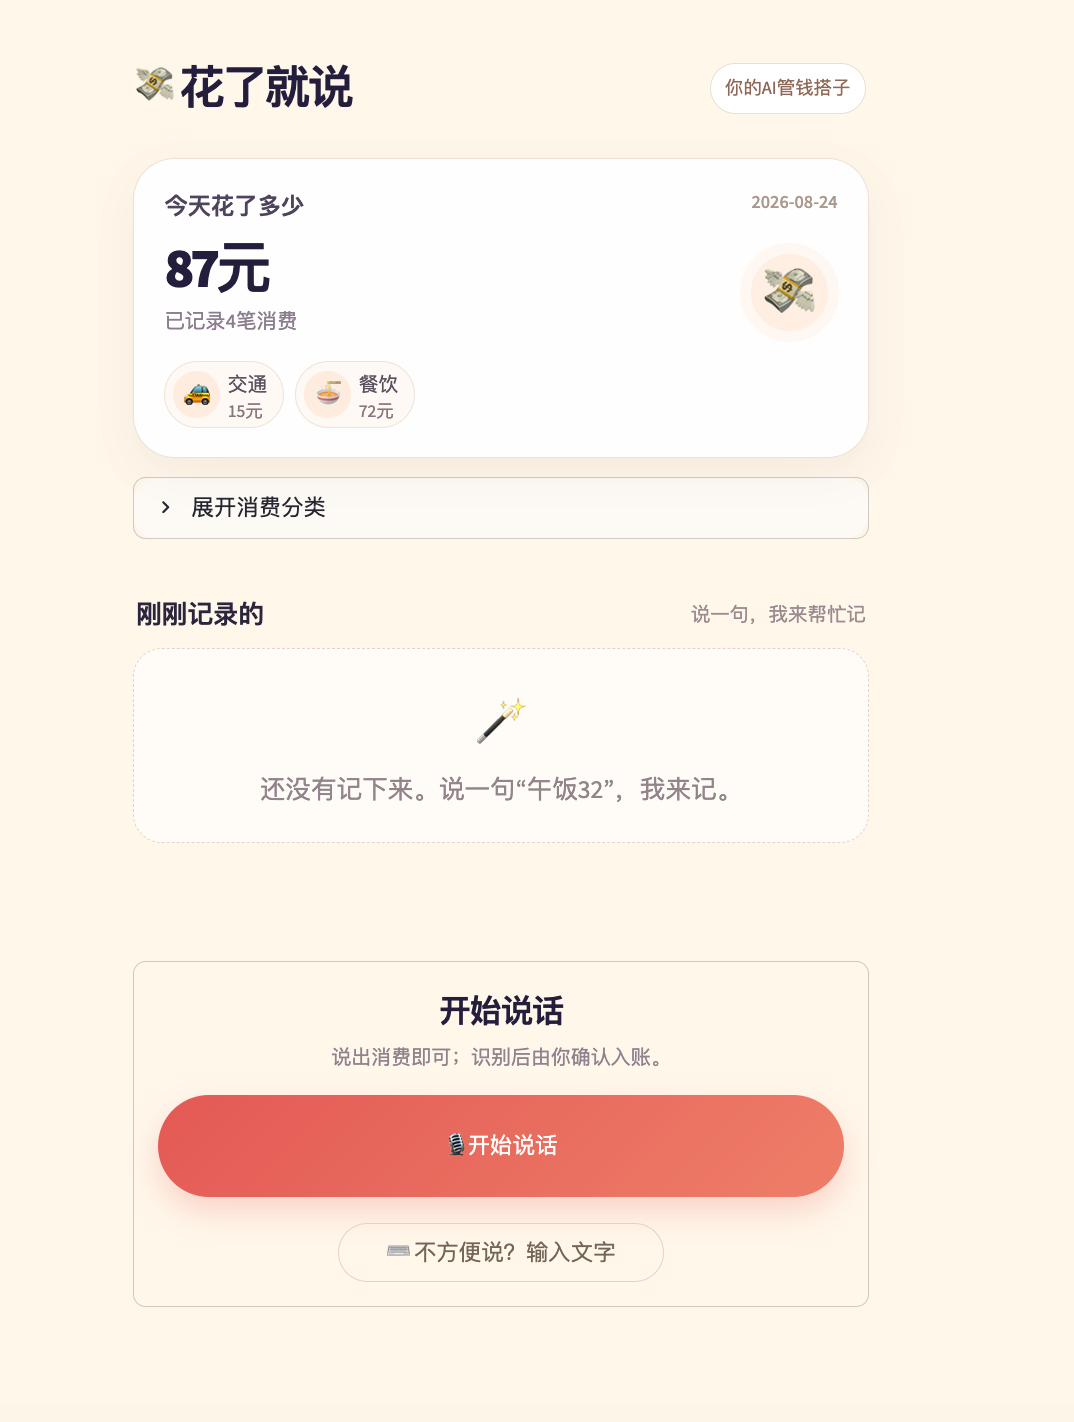
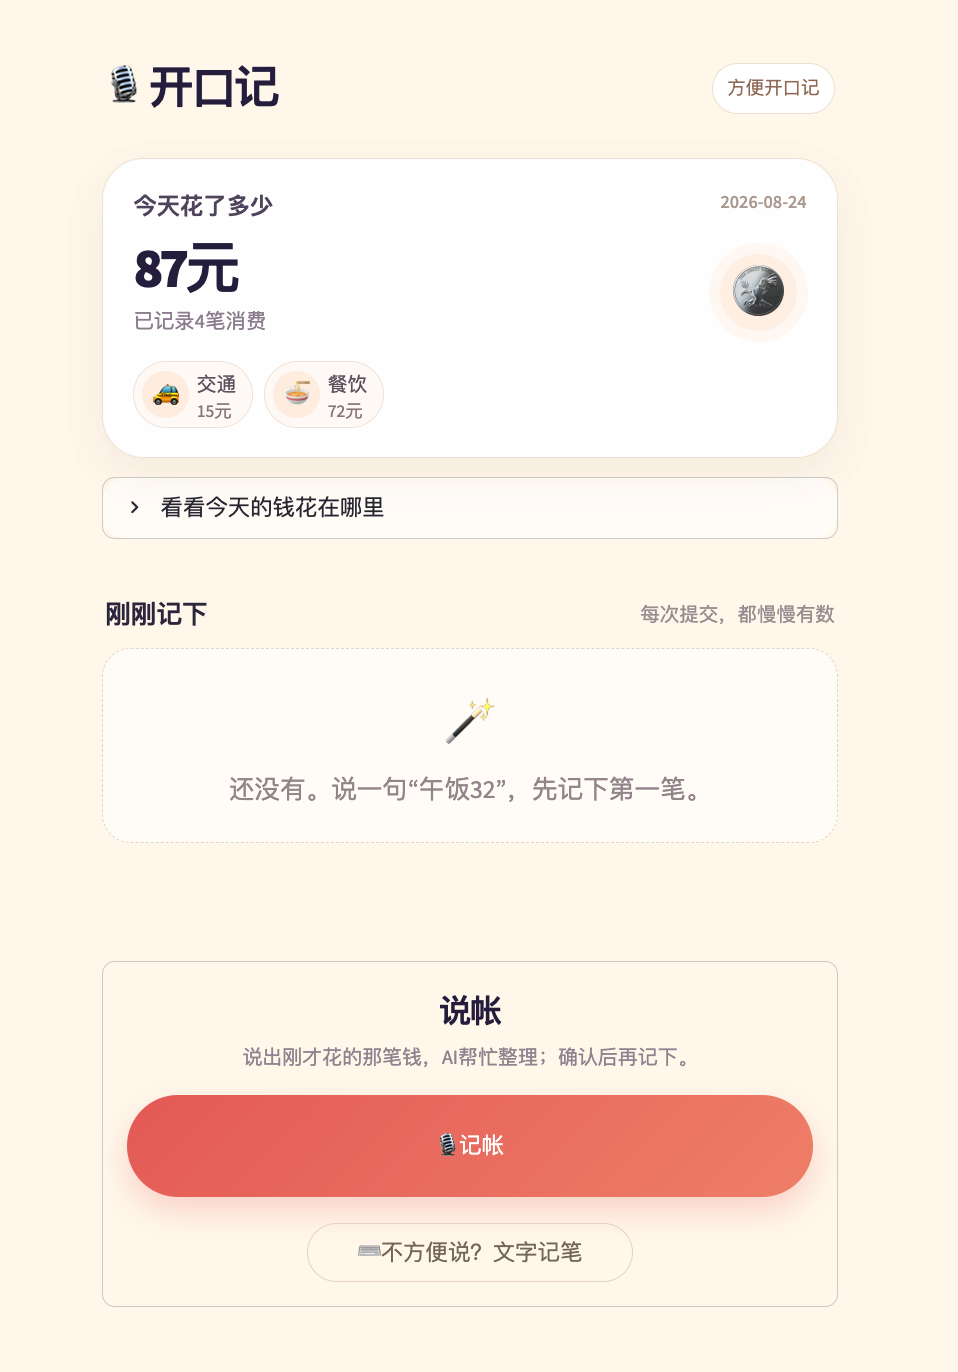
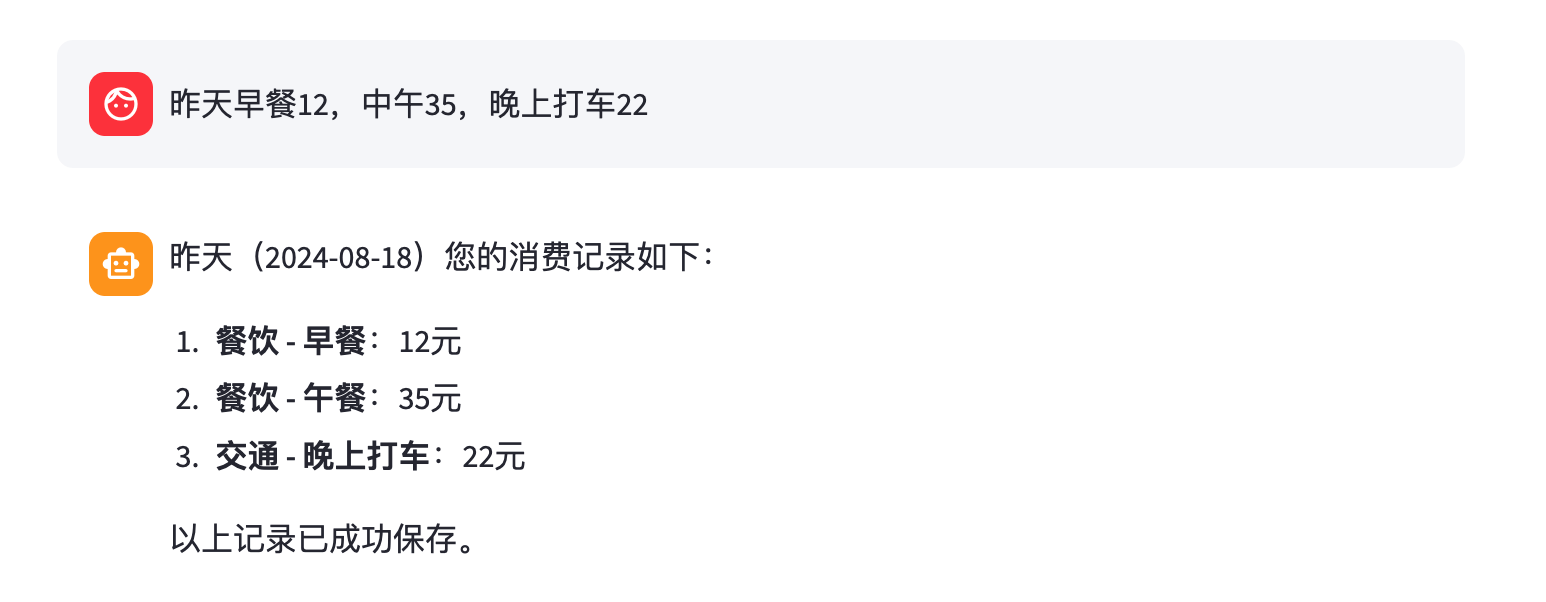
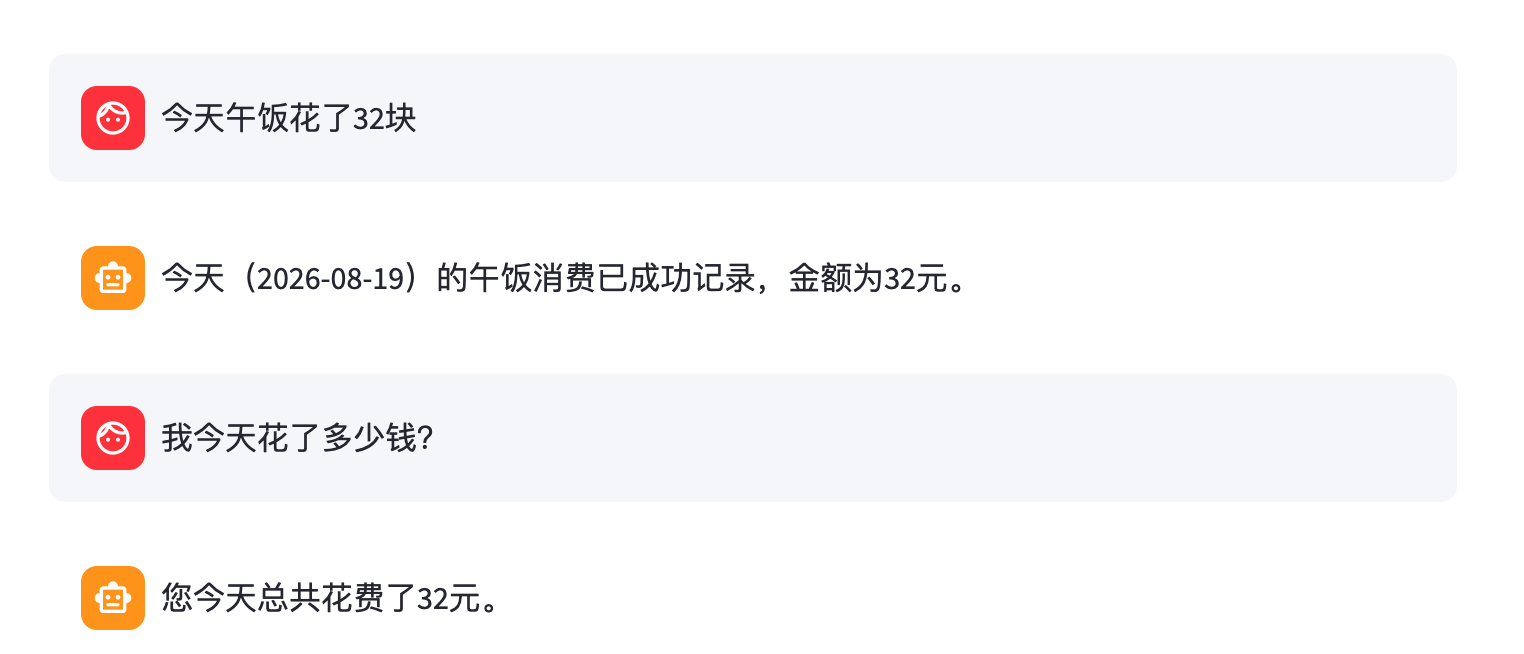
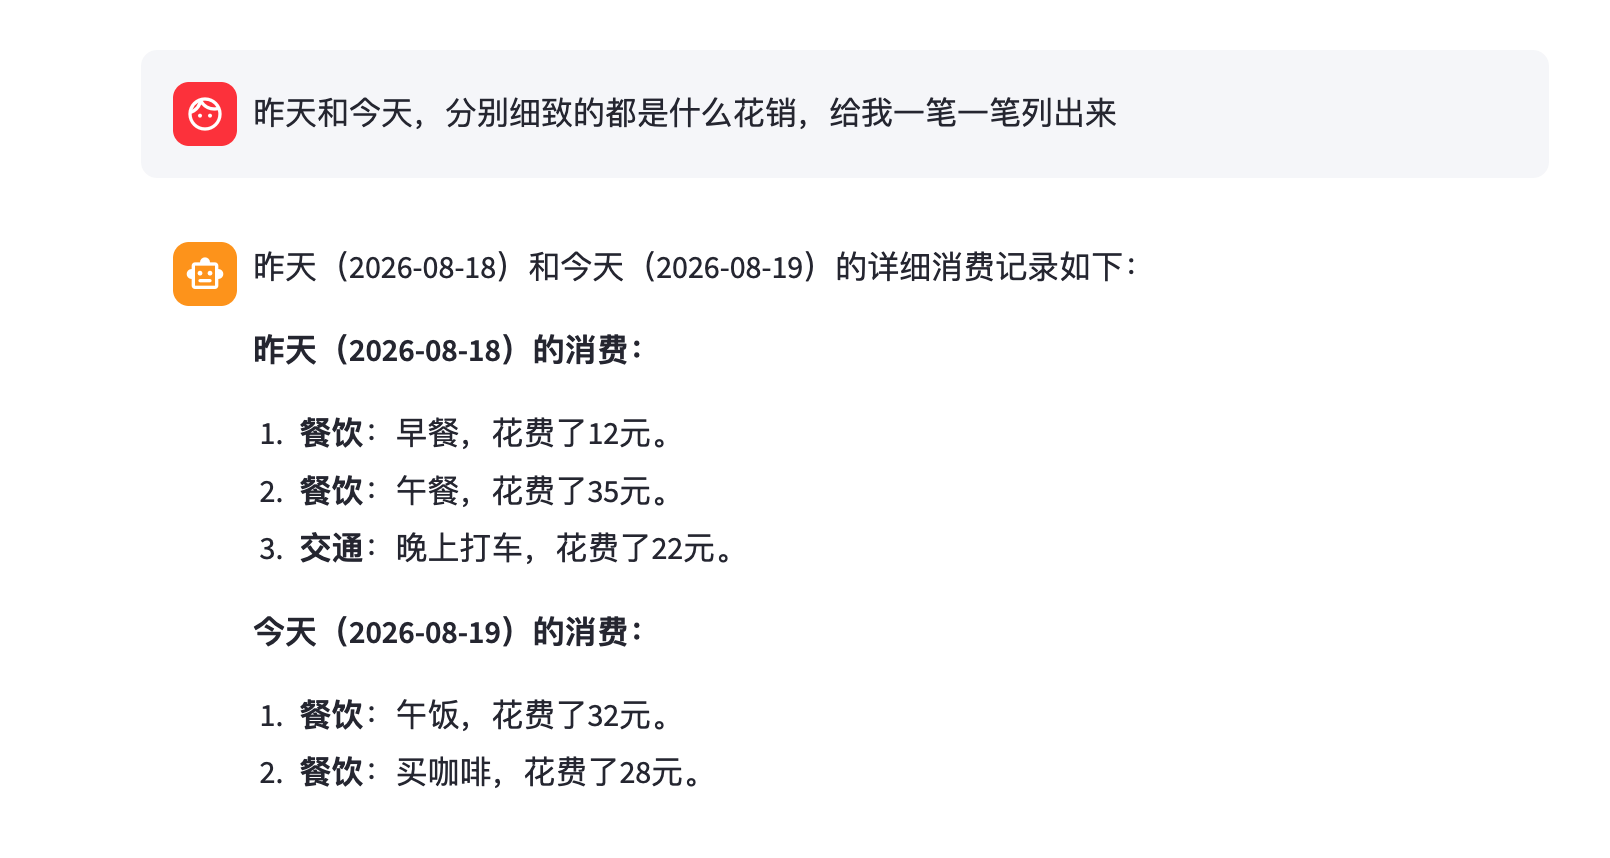
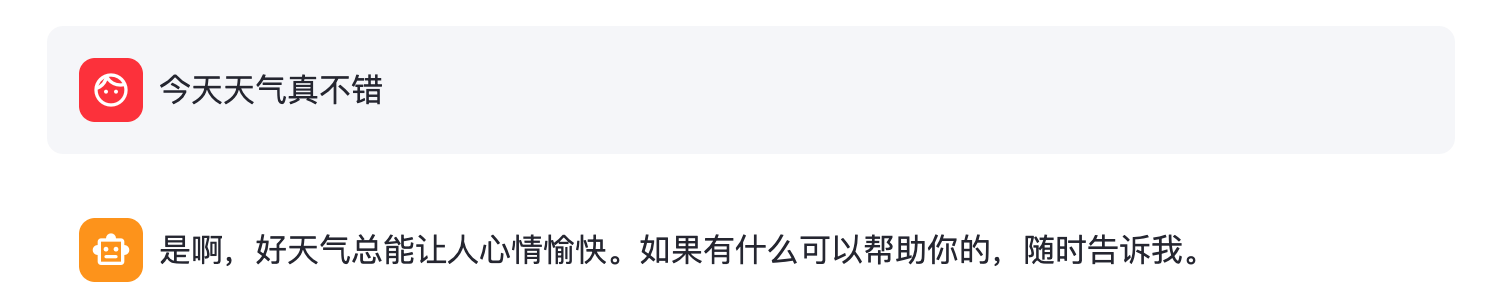
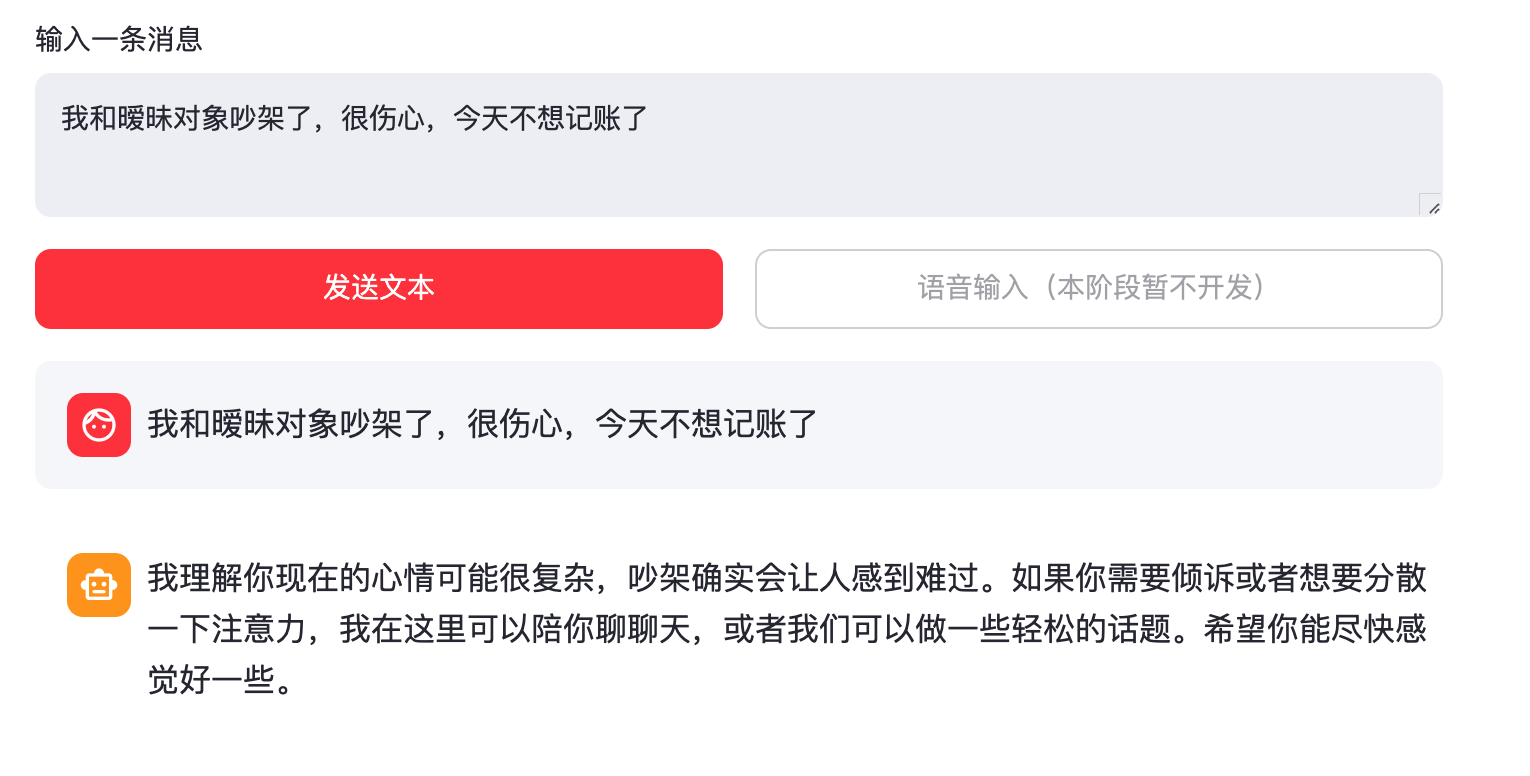
以下为页面迭代与真实线上联调截图;具体证据在验证章节中有对应场景。
06
离线自动测试 + 真实页面人工联调:Moonshot(Kimi)、百度智能云 STT、页面录音与 SQLite 的单笔、多笔、纠错、闲聊边界和查询链路。
尚未声称真实目标用户可用性、长期留存、效率提升百分比或用户满意度;这些需要下一轮对照测试验证。
| ID | 场景 | 输入 / 前置 | 预期 Tool 或结果 | 状态 |
|---|---|---|---|---|
| B01 | 单笔写入 | 午饭 32,餐饮 | 写入 1 条 | 通过 |
| B02 | 多笔写入 | 午饭 32、打车 22 | 2 条,54 元 | 通过 |
| B03/B04 | 日期查询 / 汇总 | 查询今日 | 返回对应记录;2 笔 54 元 | 通过 |
| A01 | 单笔自然语言 | 今天午饭 32 | 日期 → 写入 | 通过 |
| A02 | 汇总查询 | 今天花多少 | 汇总;不写库 | 通过 |
| A03/A07 | 普通聊天边界 | 天气真不错 | 不调 Tool;记录不变 | 通过 |
| A04 | 一句多笔 | 早餐 10、打车 22 | 两次写入;32 元 | 通过 |
| A05/A06 | 补记 / 明细 | 昨天咖啡 25;查明细 | 正确日期;不多写 | 通过 |
| A08 | 跨日多笔 / 低 RPM | 昨天 30、今天 28+15 | 3 笔 73 元;无额外模型往返 | 通过 |
| V01/V02 | 单笔 / 多笔语音 | 模拟 STT | 确认后写入 28;或 3 笔 69 | 离线通过 |
| V03 | 转写修正 | 82 改为 28 | 仅写确认的 28 | 离线通过 |
| V04 | STT 凭证缺失 | 未配置 Key | 清晰错误;不调 Agent、不写库 | 离线通过 |
| ID | 真实结果 |
|---|---|
| L01 | 午饭 32:Moonshot 调日期与写入;SQLite 成功写餐饮 32。 |
| L02 | 今日花多少:get_daily_summary 返回 32。 |
| L03 / L10 | 天气真不错:正常聊天;SQLite 记录不变,未显示 Tool Calling。 |
| L04 | 昨天早餐 12、中午 35、打车 22:一句写入 3 笔。 |
| L05 | 今天咖啡 28:与午饭共同构成当日 60。 |
| L06 | 跨日期明细:两天 5 笔,日期、类别、金额一致。 |
| L07 | 跨日总额:昨天 69、今天 60、合计 129。 |
| L08 | 两日汇总:返回类别汇总。 |
| L09 | 分类汇总:餐饮 127、交通 22,并列明细。 |
| L11 | 情绪表达:正常回应,未观察到误记账。 |
聊天边界是否写库仍以发送前后记录数 / 总额不变的自动化断言为最终证据,相关编排层测试已覆盖。
| Case | 输入 / 操作 | 预期与当前验证结论 |
|---|---|---|
| 自动转写 | 录音后停止。 | 自动出现转写状态与可编辑结果,不自动记账。 |
| 单笔记录 | “今天下午买咖啡花了二十八块”。 | 确认后记录,并可通过今日汇总查询。 |
| 多笔记录 | “昨天早餐十二块,中午吃饭三十五,晚上打车二十二”。 | 新增 3 笔消费记录,新增合计 69 元。 |
| STT 修正 | 将“二十八”手动修改为“十八”后确认。 | 最终仅写入 18 元;验证用户确认值覆盖 STT 误识别结果。 |
| 非记账边界 | “今天天气真不错”。 | 正常回复,但不新增消费记录。 |
| 查询边界 | “我今天花了多少钱?”。 | 返回来自真实 SQLite 的消费汇总,不新增消费记录。 |
| 待验证指标 | 回答的问题 |
|---|---|
| 单笔步骤 / 耗时 vs 传统记账 | 是否真的降低记录成本。 |
| 录音到成功入账的完成率与耗时 | 主场景端到端是否顺畅。 |
| STT 修改率、分类接受率、多笔一次成功率 | 真实语料与分类体系的综合可靠性。 |
| Voice-first 首选率 / 文字备选率 | 公共场景、环境噪声下的真实偏好。 |
| 确认步骤接受度与主观低摩擦反馈 | 一次确认是否值得保留。 |
将设计同一笔消费的传统 / money mate 对照任务,覆盖“消费后立刻说一句”与“一次语音说多笔”,记录步骤、耗时、完成率、修改类型与访谈反馈;按 异常场景优先级迭代 Prompt、分类与交互后复测。
07
| 风险 / 异常场景 | 当前保障机制 | 边界 |
|---|---|---|
| STT 误识金额 | 转写可编辑;确认后进入 Agent;改 18 后只写 18。 | 不声称 STT 永不出错。 |
| 闲聊 / 情绪被误当记账 | 意图 / Tool 边界;非记账测试后不新增记录。 | 不等同所有表达零误判。 |
| LLM 说成功、实际未写库 | 成功反馈基于 Tool Result;Tool / SQLite 证明。 | 仍需异常场景测试。 |
| Moonshot 3 RPM | 减少无价值模型往返,确定性反馈不额外调模型。 | 重试 / 退避属于后续优化。 |
| 凭证泄露 | 环境变量管理服务凭证。 | 未声称加密、审计等未实现能力。 |
真实消费数据里,一次有价值的确认,优于一次错误的自动化。
模糊理解交给 AI,确定性执行交给 Tool。不要为了 AI Native 而把所有业务逻辑交给 LLM。
仍要验证 模型能力 × 用户场景 × Prompt × 分类体系 × Interaction 是否真正组成低摩擦体验。
08